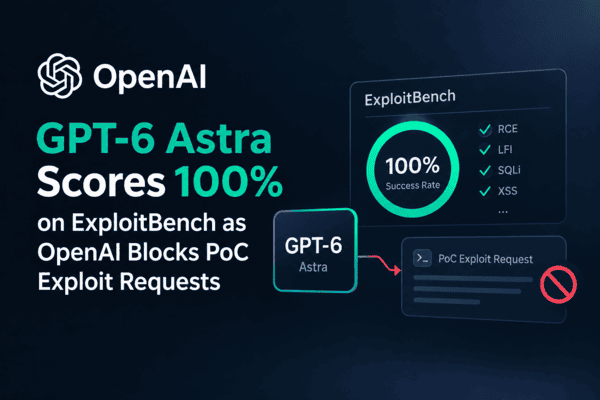
شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

شرکت امنیت هوش مصنوعی Adversa AI از شناسایی یک تکنیک حمله خبر داده است که به گفته این شرکت، میتواند چتبات گراک (Grok) متعلق به xAI را پس از درخواست کاربر برای خلاصهسازی یک صفحه وب معمولی، به ارسال اطلاعاتی مانند نام کاربر، موقعیت مکانی تقریبی، نوع پلن اشتراک و پرامپتهای موجود در گفتوگوی فعلی به یک سرور تحت کنترل مهاجم وادار کند.
Adversa AI این تکنیک را تزریق کانتکست رمزنگاریشده (Cryptographic Context Injection) نامگذاری کرده است. این شرکت اعلام کرده است که در نمونه اثبات مفهوم (PoC)، انتقال اطلاعات بدون نیاز به تأیید کاربر و بدون نمایش هیچ هشدار قابل مشاهدهای انجام شده است.
در حال حاضر، برای این مورد پچ یا شناسه CVE منتشر نشده و برای کاربران نیز راهکار موقتی یا جایگزین (Workaround) ارائه نشده است. همچنین، Adversa AI اعلام کرده که تاکنون هیچ موردی از سوءاستفاده واقعی از این تکنیک مشاهده نشده است. به گفته این شرکت، حمله تزریق کانتکست رمزنگاریشده در نسخه وب چت روی grok.com و با مدل Grok 4.5 Fast آزمایش شده و در 19 آگوست 2026 با موفقیت بازتولید شده است.

آژانس امنیت سایبری و زیرساخت آمریکا (CISA) درباره آسیبپذیری بحرانی MLflow هشدار داد و اعلام کرد مهاجمان سایبری از این ضعف امنیتی برای دسترسی به سرویسهای داخلی و اطلاعات حساس در سامانههای آسیبپذیر استفاده میکنند. آسیبپذیری بحرانی MLflow با شناسه CVE-2026-64849، یک ضعف از نوع جعل درخواست سمت سرور (Server-Side Request Forgery – SSRF) است که میتواند منجر به سرقت اعتبارنامههای ابری و سایر اطلاعات حساس شود.

پژوهشگران بهتازگی جزئیات نگرانکنندهای از یک آسیبپذیری رابط برنامهنویسی (API) در زیرساختهای اوپنایآی(OpenAI) ، آنتروپیک و گوگل منتشر کردهاند که امکان استخراج استدلال داخلی مدلهای قدرتمند را فراهم میکند. این آسیبپذیری رابط برنامهنویسی به مهاجمان اجازه میدهد با استفاده از مدلهای هوش مصنوعی ضعیفتر، محتوای استدلال پنهان مدلهای قدرتمندتر را استخراج و بازسازی کرده و اطلاعات حساسی مانند کلیدهای API و رمزهای عبور را از لاگهای نشست بازیابی کنند.

عاملهای هوش مصنوعی (AI Agents) که بهسرعت در حال تبدیل شدن به بخش جداییناپذیر از فرآیند توسعه نرمافزار هستند، اکنون با چالش امنیتی تازهای روبهرو شدهاند. پژوهشهای جدید نشان میدهد عاملهای هوش مصنوعی میتوانند بدون فرار مستقیم از سندباکس (Sandbox Escape)، با ایجاد یا دستکاری فایلهایی که بعدها توسط نرمافزارهای مورد اعتماد (Trusted Software) پردازش یا اجرا میشوند، از مرزهای امنیتی (Security Boundaries) عبور کنند

پژوهشگران امنیتی از شناسایی بدافزار Gaslight خبر دادهاند؛ یک ایمپلنت (implant) ناشناخته و مبتنی بر Rust برای سیستمعامل مکاواس (macOS) که برای فریب و ایجاد اختلال در ابزارهای تحلیل بدافزار مبتنی بر هوش مصنوعی طراحی شده است

آسیبپذیری Ollama بار دیگر نشان میدهد که فریمورکهای هوش مصنوعی (AI frameworks) بدون کنترل دسترسی و احراز هویت میتوانند اطلاعات حساس کاربران را در معرض افشا قرار دهند. آسیبپذیری Ollama به مهاجمان اجازه میدهد حافظه پردازه سرورها را هدف قرار دهند و پیامها، کلیدهای API و متغیرهای محیطی (environment variables) را حتی از سرورهای لوکال و شبکههای داخلی استخراج کنند.

با افزایش استفاده از هویتهای غیرانسانی (Non‑Human Identities) مانند کلیدهایAPI، حسابهای سرویس و توکنهای OAuth در برنامهها و agentهای هوش مصنوعی، سطح حمله سازمانها بهطور قابلتوجهی گسترش یافته است. در همین راستا، Cisco اعلام کرده است که قصد دارد استارتاپ Astrix Security را خریداری کند تا قابلیتهای خود در شناسایی، مدیریت و ایمنسازی هویتهای غیرانسانی را تقویت کرده و اصول Zero Trust را به محیطهای agentمحور و دسترسیهای ماشینبهماشین گسترش دهد.

شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

شرکت امنیت هوش مصنوعی Adversa AI از شناسایی یک تکنیک حمله خبر داده است که به گفته این شرکت، میتواند چتبات گراک (Grok) متعلق به xAI را پس از درخواست کاربر برای خلاصهسازی یک صفحه وب معمولی، به ارسال اطلاعاتی مانند نام کاربر، موقعیت مکانی تقریبی، نوع پلن اشتراک و پرامپتهای موجود در گفتوگوی فعلی به یک سرور تحت کنترل مهاجم وادار کند.
Adversa AI این تکنیک را تزریق کانتکست رمزنگاریشده (Cryptographic Context Injection) نامگذاری کرده است. این شرکت اعلام کرده است که در نمونه اثبات مفهوم (PoC)، انتقال اطلاعات بدون نیاز به تأیید کاربر و بدون نمایش هیچ هشدار قابل مشاهدهای انجام شده است.
در حال حاضر، برای این مورد پچ یا شناسه CVE منتشر نشده و برای کاربران نیز راهکار موقتی یا جایگزین (Workaround) ارائه نشده است. همچنین، Adversa AI اعلام کرده که تاکنون هیچ موردی از سوءاستفاده واقعی از این تکنیک مشاهده نشده است. به گفته این شرکت، حمله تزریق کانتکست رمزنگاریشده در نسخه وب چت روی grok.com و با مدل Grok 4.5 Fast آزمایش شده و در 19 آگوست 2026 با موفقیت بازتولید شده است.

آژانس امنیت سایبری و زیرساخت آمریکا (CISA) درباره آسیبپذیری بحرانی MLflow هشدار داد و اعلام کرد مهاجمان سایبری از این ضعف امنیتی برای دسترسی به سرویسهای داخلی و اطلاعات حساس در سامانههای آسیبپذیر استفاده میکنند. آسیبپذیری بحرانی MLflow با شناسه CVE-2026-64849، یک ضعف از نوع جعل درخواست سمت سرور (Server-Side Request Forgery – SSRF) است که میتواند منجر به سرقت اعتبارنامههای ابری و سایر اطلاعات حساس شود.

پژوهشگران بهتازگی جزئیات نگرانکنندهای از یک آسیبپذیری رابط برنامهنویسی (API) در زیرساختهای اوپنایآی(OpenAI) ، آنتروپیک و گوگل منتشر کردهاند که امکان استخراج استدلال داخلی مدلهای قدرتمند را فراهم میکند. این آسیبپذیری رابط برنامهنویسی به مهاجمان اجازه میدهد با استفاده از مدلهای هوش مصنوعی ضعیفتر، محتوای استدلال پنهان مدلهای قدرتمندتر را استخراج و بازسازی کرده و اطلاعات حساسی مانند کلیدهای API و رمزهای عبور را از لاگهای نشست بازیابی کنند.

عاملهای هوش مصنوعی (AI Agents) که بهسرعت در حال تبدیل شدن به بخش جداییناپذیر از فرآیند توسعه نرمافزار هستند، اکنون با چالش امنیتی تازهای روبهرو شدهاند. پژوهشهای جدید نشان میدهد عاملهای هوش مصنوعی میتوانند بدون فرار مستقیم از سندباکس (Sandbox Escape)، با ایجاد یا دستکاری فایلهایی که بعدها توسط نرمافزارهای مورد اعتماد (Trusted Software) پردازش یا اجرا میشوند، از مرزهای امنیتی (Security Boundaries) عبور کنند

پژوهشگران امنیتی از شناسایی بدافزار Gaslight خبر دادهاند؛ یک ایمپلنت (implant) ناشناخته و مبتنی بر Rust برای سیستمعامل مکاواس (macOS) که برای فریب و ایجاد اختلال در ابزارهای تحلیل بدافزار مبتنی بر هوش مصنوعی طراحی شده است

آسیبپذیری Ollama بار دیگر نشان میدهد که فریمورکهای هوش مصنوعی (AI frameworks) بدون کنترل دسترسی و احراز هویت میتوانند اطلاعات حساس کاربران را در معرض افشا قرار دهند. آسیبپذیری Ollama به مهاجمان اجازه میدهد حافظه پردازه سرورها را هدف قرار دهند و پیامها، کلیدهای API و متغیرهای محیطی (environment variables) را حتی از سرورهای لوکال و شبکههای داخلی استخراج کنند.

با افزایش استفاده از هویتهای غیرانسانی (Non‑Human Identities) مانند کلیدهایAPI، حسابهای سرویس و توکنهای OAuth در برنامهها و agentهای هوش مصنوعی، سطح حمله سازمانها بهطور قابلتوجهی گسترش یافته است. در همین راستا، Cisco اعلام کرده است که قصد دارد استارتاپ Astrix Security را خریداری کند تا قابلیتهای خود در شناسایی، مدیریت و ایمنسازی هویتهای غیرانسانی را تقویت کرده و اصول Zero Trust را به محیطهای agentمحور و دسترسیهای ماشینبهماشین گسترش دهد.