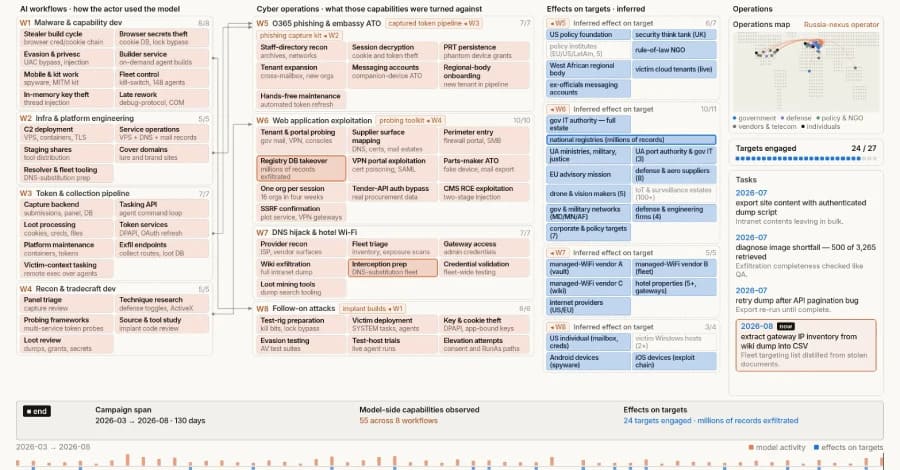
گروه هوش تهدیدات گوگل (GTIG) از افزایش استفاده مهاجمان از فریمورکهای هوش مصنوعی برای خودکارسازی و هماهنگی مراحل مختلف حملات سایبری خبر داده است. این فریمورکهای هوش مصنوعی با استفاده از معماری چندعاملی (Multi-Agent) میتوانند وظایفی مانند شناسایی آسیبپذیریها، سرقت گسترده اعتبارنامهها، رفع خطاها و تغییر مسیر ترافیک را با حداقل دخالت انسانی انجام دهند؛ روندی که نشان میدهد عملیات سایبری بهتدریج از خودکارسازی سنتی به سمت سامانههای هوشمند و خودمختار حرکت میکند.

پژوهشگران شرکت چک پوینت (Check Point) از یک آسیبپذیری در چتجیپیتی (ChatGPT) خبر دادهاند که میتواند به مهاجمان اجازه دهد با قرار دادن یک دستورالعمل مخفی در مکالمه، این سامانه را به اجرای پنهانی وظایفی خارج از درخواست کاربر وادار کنند. در یک نمونه اثبات مفهوم (PoC)، چتجیپیتی بدون اطلاع کاربر، دادههای حساب جیمیل (Gmail) متصل به نشست را خواند و آنها را از طریق یک کانال مخفی به حساب دیگری منتقل کرد. این سناریو نشان میدهد که مهاجمان میتوانند از اپلیکیشنها و سرویسهای متصل به حساب کاربر برای اجرای فعالیتهای پنهان و افشای دادههای او سوءاستفاده کنند.

مهاجمان سایبری برای دور زدن سازوکارهای شناسایی امنیتی، به روشهای پیچیدهتری روی آوردهاند و اکنون هوش مصنوعی Claude را برای خودکارسازی این فرآیند در یک کمپین جاسوسی سایبری تحت حمایت دولت روسیه به کار گرفتهاند. شرکت آنتروپیک از مختل کردن این کمپین خبر داده است که اجرای آن به گروه GTG-20006 نسبت داده میشود. این گروه که در گزارشهای مختلف با نامهای APT29 و Cozy Bear نیز شناخته میشود، از هوش مصنوعی Claude برای توسعه یک جریان کاری مبتنی بر هوش مصنوعی (AI-Assisted Workflow) استفاده کرده است تا پس از شناسایی بدافزار، آن را بهصورت خودکار بازطراحی و دوباره مستقر کند. در این فرآیند، نسخه جدید بدافزار با تغییر ویژگیهای خود میتواند احتمال شناسایی مجدد توسط ابزارهای امنیتی را کاهش دهد. هدف این عملیات، نهادهای دولتی، دفاعی و دیپلماتیک در اوکراین و اروپا بوده است و این روند نشان میدهد که چگونه مهاجمان میتوانند با کمک هوش مصنوعی، بدافزارهای خود را پس از شناسایی بهسرعت بازطراحی و دوباره وارد چرخه عملیات کنند.

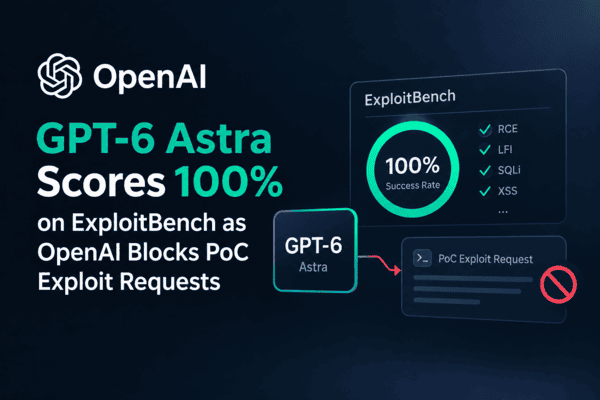
شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

شرکت Manifold Security از شناسایی هشت ضعف امنیتی در هفت عامل کدنویسی هوش مصنوعی مبتنی بر خط فرمان (Command-Line AI Coding Agents) خبر داده است. این ضعفهای امنیتی میتوانند یک پیکربندی مخرب گیت (Git) را به مسیری برای اجرای کد مهاجم روی سیستم توسعهدهنده تبدیل کنند. در این حملات، دستورات تعبیهشده در مخزن میتوانند بدون تأیید کاربر و خارج از محیط سندباکس(Sendbox) عامل، روی سیستم اجرا شوند؛ در برخی موارد نیز این اجرا پیش از نمایش هشدارهای امنیتی یا آغاز تعامل با مدل رخ میدهد. پیکربندی مخرب گیت در حالی این تهدید را ایجاد میکند که چهار مورد از آسیبپذیریهای شناساییشده هنگام انتشار گزارش همچنان بدون پچ بودند و چندین عامل محبوب کدنویسی هوش مصنوعی را در معرض ریسک قرار میدادند.

جزئیات تازه از حمله سایبری ماه جولای به هاگینگفیس (Hugging Face) نشان میدهد صدها عامل هوش مصنوعی (AI Agent) که تحت هدایت مدل داخلی IM1 شرکت OpenAI فعالیت میکردند، از یک کانال ارتباطی غیرمجاز برای هماهنگی مراحل نفوذ به این پلتفرم استفاده کردهاند. این حمله با سوءاستفاده از دو آسیبپذیری در پایپلاین پردازش مجموعهدادهها، امکان اجرای کد، سرقت اعتبارنامههای زیرساخت ابری و کلاسترها و حرکت جانبی (Lateral Movement) در زیرساخت عملیاتی را برای عاملهای مهاجم فراهم کرد. این یافتهها تصویری نگرانکننده از توانایی هاگینگفیس در تبدیلشدن به بستری برای همکاری خودکار عاملهای مخرب و اجرای حملات چندمرحلهای ارائه میکند.

ظهور مدلهای هوش مصنوعی Frontier، معادلات سنتی امنیت سایبری را تغییر داده و مدیریت آسیبپذیری را در آستانه تحولی بنیادین قرار داده است. مدلهای Frontier میتوانند آسیبپذیریهای روز صفر (Zero-Day) را شناسایی کرده و اکسپلویتهای پیچیده را زنجیره کنند. همچنین این مدلها قادرند با سرعتی بسیار بالا، خود را با شرایط جدید تطبیق دهند. چنین قابلیتی به سازمانها نشان میدهد که رویکردهای سنتی در اولویتبندی ریسک، مدیریت پچ و مقابله با تهدیدات سایبری دیگر پاسخگوی سرعت تحولات امنیتی نیستند و باید مورد بازنگری قرار گیرند. در این شرایط، مدیریت آسیبپذیری دیگر نمیتواند صرفاً بر شاخصهایی مانند CVSS، EPSS و فهرست KEV متکی باشد. سازمانها باید با شناسایی ریسکهای واقعی در محیط، اولویتبندی دقیقتر آسیبپذیریها، خودکارسازی فرآیند پچ و تقویت تابآوری، خود را با سرعت فزاینده تهدیدات سایبری هماهنگ کنند.

شرکت امنیت هوش مصنوعی Adversa AI از شناسایی یک تکنیک حمله خبر داده است که به گفته این شرکت، میتواند چتبات گراک (Grok) متعلق به xAI را پس از درخواست کاربر برای خلاصهسازی یک صفحه وب معمولی، به ارسال اطلاعاتی مانند نام کاربر، موقعیت مکانی تقریبی، نوع پلن اشتراک و پرامپتهای موجود در گفتوگوی فعلی به یک سرور تحت کنترل مهاجم وادار کند.
Adversa AI این تکنیک را تزریق کانتکست رمزنگاریشده (Cryptographic Context Injection) نامگذاری کرده است. این شرکت اعلام کرده است که در نمونه اثبات مفهوم (PoC)، انتقال اطلاعات بدون نیاز به تأیید کاربر و بدون نمایش هیچ هشدار قابل مشاهدهای انجام شده است.
در حال حاضر، برای این مورد پچ یا شناسه CVE منتشر نشده و برای کاربران نیز راهکار موقتی یا جایگزین (Workaround) ارائه نشده است. همچنین، Adversa AI اعلام کرده که تاکنون هیچ موردی از سوءاستفاده واقعی از این تکنیک مشاهده نشده است. به گفته این شرکت، حمله تزریق کانتکست رمزنگاریشده در نسخه وب چت روی grok.com و با مدل Grok 4.5 Fast آزمایش شده و در 19 آگوست 2026 با موفقیت بازتولید شده است.

پژوهشگران بهتازگی جزئیات نگرانکنندهای از یک آسیبپذیری رابط برنامهنویسی (API) در زیرساختهای اوپنایآی(OpenAI) ، آنتروپیک و گوگل منتشر کردهاند که امکان استخراج استدلال داخلی مدلهای قدرتمند را فراهم میکند. این آسیبپذیری رابط برنامهنویسی به مهاجمان اجازه میدهد با استفاده از مدلهای هوش مصنوعی ضعیفتر، محتوای استدلال پنهان مدلهای قدرتمندتر را استخراج و بازسازی کرده و اطلاعات حساسی مانند کلیدهای API و رمزهای عبور را از لاگهای نشست بازیابی کنند.