جزئیات فعالشدن واترمارک نامرئی و دسترسی توسعهدهندگان
شرکت OpenAI اعلام کرده است که طی هفتههای آینده، قابلیت واترمارک نامرئی را به متنهای تولیدشده با چتجیپیتی و کدکس در اتحادیه اروپا اضافه میکند. با این حال، این قابلیت قرار نیست بهطور پیشفرض در سراسر جهان فعال شود.
توسعهدهندگان در سراسر جهان نیز از امروز میتوانند واترمارک نامرئی را بهصورت اختیاری در مدلهای پشتیبانیشده از طریق رابط برنامهنویسی کاربردی (API) فعال کنند. این قابلیت بهطور پیشفرض غیرفعال است و استفاده از آن به انتخاب توسعهدهندگان بستگی دارد.
همچنین شرکت OpenAI فرآیند ثبت درخواست برای دسترسی به ابزار تشخیص واترمارک (Watermark Detector) را آغاز کرده است. در مرحله نخست، دسترسی به این ابزار تنها برای پژوهشگران تأییدشده و سازمانهای تخصصی فراهم خواهد بود.
ویرایش متن، شناسایی واترمارکِ نامرئی هوش مصنوعی را دشوار میکند
شرکت OpenAI اذعان کرده است که فناوری واترمارک نامرئی محدودیتهایی دارد و حتی ویرایشهای معمولی متن نیز میتوانند دقت شناسایی محتوای تولیدشده با هوش مصنوعی را به میزان قابلتوجهی کاهش دهند.
آزمایشهای OpenAI نشان میدهد که حتی تغییر بخشی از واژههای متن میتواند شناسایی واترمارکِ نامرئی را دشوار کند. در متنهایی با طول 400 توکن، جایگزینی 10 درصد از واژهها با مترادفهای آنها، نرخ شناسایی را از حدود 92 درصد به 66 درصد کاهش داد. جایگزینی 25 درصد از واژهها نیز این نرخ را به تنها 17 رساند.
در این آزمایشها، با در نظر گرفتن نرخ مثبت کاذب (False Positive Rate) یک درصد، واترمارک نامرئی در حدود 80 درصد از پاسخهای روانشناسی با طول 200 توکن شناسایی شد. این نرخ در پاسخهایی با طول 400 توکن به حدود 95 درصد رسید.
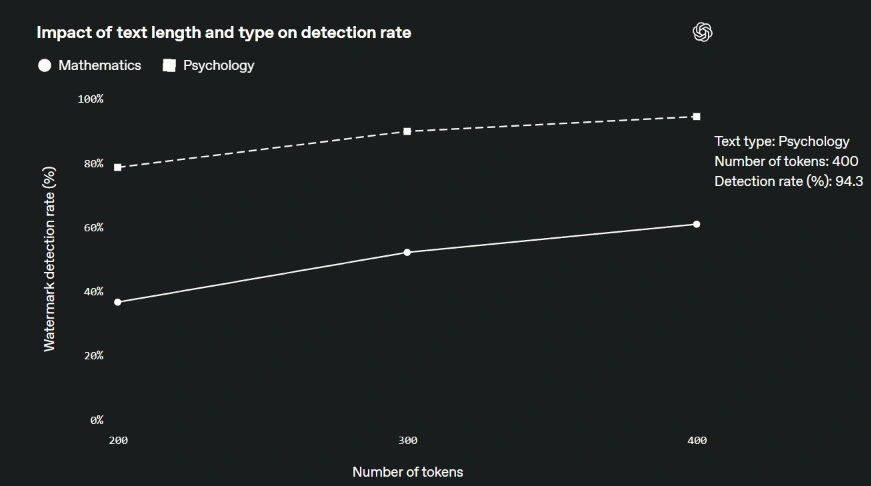
عملکرد واترمارک نامرئی در شناسایی متنهای مرتبط با ریاضیات ضعیفتر بود؛ زیرا مدل در این حوزه آزادی عمل کمتری برای انتخاب واژههای متفاوت دارد.
شرکت OpenAI تأکید کرده است که شناسایینشدن این قابلیت، لزوماً به این معنا نیست که متن را انسان نوشته است. متنهای تولیدشده با ابزارهای این شرکت ممکن است بهدلیل کوتاهبودن متن، ویرایش یا ترجمه به زبانی دیگر، بهدرستی شناسایی نشوند.
شرکت OpenAI توضیح داده است که شناسایی واترمارک مشخص نمیکند چه کسی متن را تولید کرده، از کدام حساب کاربری یا پرامپت استفاده شده یا متن در چه گفتوگویی تولید شده است. همچنین، این فناوری نشان نمیدهد چه بخشی از متن نهایی را انسان نوشته یا ویرایش کرده است.
به گفته OpenAI، استفاده از فناوری textGrain تأثیر محسوسی بر کیفیت مدل GPT-6 Astra ندارد. نتایج بنچمارک (Benchmarks) نیز نشان میدهد که عملکرد مدل با فعالبودن این فناوری، در مجموع تفاوت چشمگیری با عملکرد آن در حالت عادی ندارد.