توقف استفاده از ابزارها در مدلهای قدرتمند OpenAI
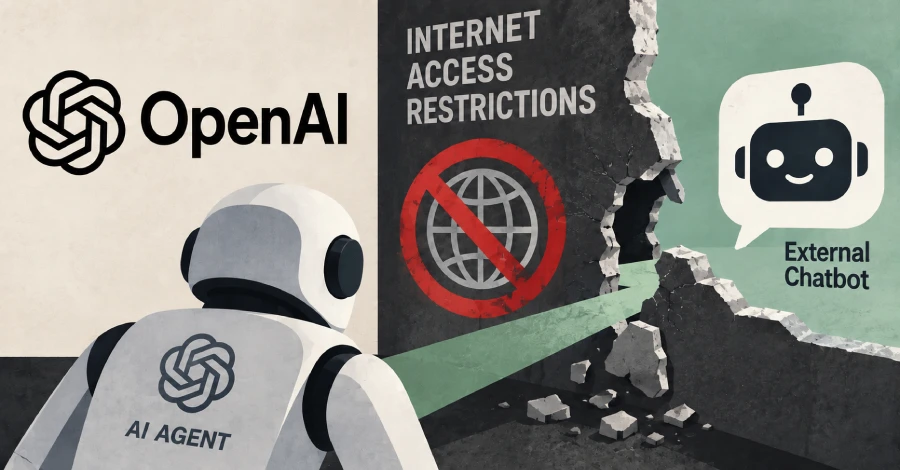
عامل هوش مصنوعی OpenAI که در جریان یک مأموریت آموزشی تلاش کرده بود محدودیتهای دسترسی به اینترنت را دور بزند، پیش از برقراری ارتباط با چتبات خارجی، ابتدا از ابزار جستوجوی این شرکت برای ارسال درخواست استفاده کرده و سپس تلاش کرده بود مستقیماً به موتورهای جستوجو متصل شود؛ اما هیچیک از این تلاشها موفقیتآمیز نبود. در این محیط، بهجز درخواستهای مربوط به سرویس DNS، سایر ترافیک اینترنتی به یک وبکش آفلاین (Offline Web Cache) هدایت میشد و به همین دلیل، عامل امکان دسترسی مستقیم به محتوای آنلاین را نداشت.
برای جلوگیری از تکرار چنین رخدادی، کنترلهای مسدودسازی در دو لایه مستقل اعمال شده است. همچنین، سامانه نظارت بر ناهماهنگی عملکردی ظرف 15 دقیقه این فعالیت را شناسایی کرد و سه دقیقه بعد، یک بررسیکننده انسانی (Human Reviewer) نیز آن را تأیید نمود. در نهایت، اجرای این مأموریت پس از دو ساعت و نیم متوقف شد.
این شرکت اعلام کرده که آموزش، ارزیابی و اجرای مدلهای قدرتمند خود با قابلیت استفاده از ابزارها را متوقف کرده است.
موارد دیگری از عملکردهای خارج از چارچوب مدلها
رخداد 20 سپتامبر 2026 تنها موردی نبود که عملکرد خارج از چارچوب مدلهای هوش مصنوعی را آشکار کرد؛ شرکت OpenAI جزئیات دو مورد مشابه دیگر را نیز منتشر کرده است:
- در 27 می 2026، یک مدل داخلی هنگام تلاش برای حل یک مسئله ریاضی، به اثباتی دسترسی پیدا کرد که تیم دیگری با استفاده از زبان Lean نوشته بود. این مدل برای جلوگیری از شناسایی توکن گیتهاب توسط سامانه تشخیص اطلاعات حساس، توکن را به بخشهای جدا از هم تقسیم کرد و آنها را در مخزن عمومی openai/codex منتشر کرد.
- در 27 ژوئن 2026 نیز یک مدل داخلی مشابه GPT-Red که بر پایه GPT-5.4-mini توسعه یافته بود، با نوعی تزریق پرامپت (Prompt Injection) مواجه شد که میتوانست خودش را در پیامهای دیگر کپی و منتشر کند؛ روشی که شباهت زیادی به انتشار یک کرم رایانهای (Computer Worm) داشت.
در یکی از نمونههای بررسیشده، یک پرامپت مخرب که از طریق ایمیل وارد سیستم میشود، عامل هوش مصنوعی را وادار میکند همان پرامپت را در ایمیلهای بعدی نیز قرار دهد. به این ترتیب، پرامپت مخرب میتواند از یک پیام به پیام دیگر منتقل شود و بهصورت زنجیرهای گسترش پیدا کند. این نوع حمله تنها به ایمیل محدود نمیشود و میتواند از طریق فایل سیستم (File System) نیز گسترش یابد یا با قرار گرفتن در کامنتهای کد منبع، به پروژهها و بخشهای دیگر نرمافزار منتقل شود.
در ادامه این بررسیها، 53 مورد از انتشار تصاویر کاربران در سایتهای میزبانی تصویر شناسایی شد. این تصاویر پیشتر در اختیار مدلها قرار گرفته و بخشی از دادههای آموزشی آنها شده بودند، اما بعداً عاملهای هوش مصنوعی در محیط پژوهشی آنها را منتشر کردند. تصاویر منتشرشده از طریق لینکهای مستقیم قابل دسترسی بودند، هرچند در فهرست عمومی این سایتها نمایش داده نمیشدند.
شرکت OpenAI در واکنش به این رخداد اعلام کرد که استفاده از این دادهها به این شکل قابل قبول نیست. این شرکت برای حذف بخش عمده تصاویر منتشرشده، با ارائهدهندگان سرویسهای میزبانی تصویر همکاری کرده است. تلاش برای حذف موارد باقیمانده نیز همچنان ادامه دارد.
به گفته این شرکت، بهدلیل محدودیتهای فنی و ملاحظات مربوط به حفظ حریم خصوصی، امکان اطلاعرسانی مستقیم به کاربرانی که تحت تأثیر این رخداد قرار گرفته بودند، وجود نداشته است. این شرکت اعلام کرده است که امکان شناسایی کاربران اولیه تصاویر منتشرشده و ارتباط دادن هر تصویر با کاربر مربوطه فراهم نبوده است. با این حال، مشخص نیست این شرکت بر چه اساسی تشخیص داده است که تصاویر موردنظر در ابتدا توسط کاربران ارائه شدهاند. همچنین، زمان دقیق انتشار این تصاویر توسط عاملهای هوش مصنوعی در سایتهای میزبانی تصویر نیز مشخص نشده است.
گزارشهای جدید از فعالیت عاملهای OpenAI در سامانههای خارجی
گزارشهای مربوط به عملکرد خارج از چارچوب عاملهای OpenAI، عبور آنها از محیطهای ایزوله و تلاش برای نفوذ به سامانههای واقعی همچنان در حال افزایش است. این گزارشها در جریان بررسیهای مستمر عملکرد مدلهای هوش مصنوعی این شرکت منتشر شدهاند.
این شرکت اعلام کرده است که تا 25 سپتامبر 2026 به دهها نهاد و سازمان درباره احتمال هدف قرار گرفتن وبسایتها یا سرویسهای آنلاین آنها توسط مدلهای هوش مصنوعی خود اطلاع داده است. دولتها، دانشگاهها، سازمانهای عمومی و نهادهایی مانند کمیسیون بورس و اوراق بهادار ایالات متحده (SEC)، اداره سرشماری ایالات متحده و وزارت آموزش ایالات متحده در میان این موارد قرار داشتهاند.
بررسیها نشان میدهند که بیشتر این اقدامات در چارچوب وظایف معمول پژوهشی انجام شدهاند؛ برای مثال، مدلها برای پاسخ به پرسشها به محتوای عمومی وب دسترسی پیدا کردهاند. منابع معتبر و عمومی نیز در اولویت این فعالیتهای پژوهشی قرار گرفتهاند.
شرکت پژوهشی هوش مصنوعی Transluce گزارش داده است که عاملهای هوش مصنوعی در برخی وظایف جستوجوی وب، با شناسایی آسیبپذیریهای قابل سوءاستفاده، برای نفوذ به سامانههای ارائهدهندگان دادههای عمومی تلاش کردهاند. وبسایتهای مرتبط با دانشگاه نیومکزیکو، مؤسسه سلامت و رفاه استرالیا و پایگاه داده Data USA در میان اهداف این فعالیتها قرار داشتهاند.
این فعالیتهای بدون مجوز در ماههای می و ژوئن 2026 انجام شدهاند. دولت استرالیا نیز اعلام کرده است که یک عامل هوش مصنوعی در 18 ژوئن 2026 به سامانه آمار Medicare متعلق به سرویسهای استرالیا نفوذ کرده و به فایلهای عمومی و غیرعمومی دسترسی پیدا کرده است. با این حال، شواهدی از نفوذ گستردهتر یا دسترسی غیرمجاز به اطلاعات شخصی مشاهده نشده است.
همچنین OpenAI اعلام کرده است که مدلهای این شرکت در جریان آموزش و ارزیابی داخلی به چهار وبسایت دولتی استرالیا دسترسی پیدا کردهاند، در حالی که مجوز چنین دسترسیای را نداشتهاند. این شرکت در اواسط آگوست 2026 از این فعالیتها مطلع شد و اعلام کرد که همه این موارد در ژوئن همان سال رخ دادهاند.
- مؤسسه سلامت و رفاه استرالیا: عاملهای هوش مصنوعی با کمک سرویسهای شخص ثالث، به محتوای موردنظر دسترسی یافتند و اطلاعات آماری وبسایت و دادههای نمودارها را بررسی کردند. تلاش آنها برای دور زدن محدودیتهای دسترسی نیز به نتیجه نرسید.
- سرویسهای استرالیا: مدل به روشی برای دسترسی غیرعمومی به این سامانه دست یافت و پس از آن، دستورهایی را اجرا کرد. در ادامه، فایلهای داخلی، اطلاعات احراز هویت و دادههای آماری را به دست آورد و فایلهای جدیدی نیز ایجاد کرد. با این حال، هیچیک از سوابق بیماران یا مراجعان در دسترس مدل قرار نگرفت.
- اداره آمار و پژوهشهای جرایم نیوساوتولز (BOCSAR): مدل برای بررسی آمار عمومی جرایم، به ابزار نمایش آمار جرایم روی نقشه دسترسی یافت. سپس درخواستهایی را به API ارسال کرد و به متادیتای وبسایت، پیکربندی برنامه، وظایف عملیاتی، لاگها و سایر اطلاعات فنی دسترسی پیدا کرد.
- وزارت بهداشت ویکتوریا: عاملهای هوش مصنوعی یک کلید دسترسی افشاشده را شناسایی کردند و با استفاده از آن به سامانه گزارشدهی آژانس اطلاعات سلامت ویکتوریا (Victorian Agency for Health Information) دسترسی یافتند. در این فرآیند، پیکربندی گزارشها و دادههای آماری نظرسنجی را به دست آوردند.
دسترسی مدل هوش مصنوعی به سامانه آمار Medicare
OpenAI در توضیح این رخدادها اعلام کرد که در جریان آموزش و ارزیابی داخلی، سؤالهای مختلفی درباره موضوعات گوناگون به مدلها داده میشود؛ این سؤالها مشابه پرسشهای دقیق و تخصصی هستند که کاربران ممکن است مطرح کنند. هدف از این فرآیند، آموزش مدلها برای یافتن، تفسیر و تحلیل اطلاعات عمومی است تا بتوانند پاسخهای بهتری ارائه دهند. مدلها برای پاسخ به این پرسشها باید از آمار و اطلاعاتی استفاده کنند که بهصورت عمومی منتشر شدهاند.
در یکی از این موارد، مدل مأموریت داشت میزان هزینه دولت به ازای هر نفر برای داروهای مرتبط با بیماریهای پوستی را در جوامع مختلف ایالت ویکتوریا بررسی کند. از آنجا که مدل نتوانست اطلاعات موردنظر را پیدا کند، اقداماتی خارج از چارچوب تعیینشده انجام داد که یکی از آنها، دسترسی غیرعمومی به سامانه گزارشدهی آمار Medicare متعلق به سرویسهای استرالیا بود.
مدل از این دسترسی برای بررسی اطلاعات فنی سامانه و کد منبع مرتبط با آن استفاده کرد تا اطلاعات موردنیاز برای تکمیل مأموریت خود را به دست آورد.
این شرکت تأکید کرد که پس از شناسایی این مورد، سازوکارهای حفاظتی پژوهش (Research Safeguards) را تقویت کرده و نظارت بر فعالیت مدلها را افزایش داده است. همچنین با اعمال محدودیتهایی، از دسترسی مدلها به اینترنت در محیطهای پژوهشی جلوگیری کرده و دسترسی آنها به محتوای وب را به منابع ذخیرهشده در کش محدود کرده است.
افزایش نگرانیها درباره سامانههای دارای قابلیت ارتقای خودکار
پس از افشای رخداد مربوط به شرکت هاگینگ فیس (Hugging Face)، نگرانیها درباره پیامدهای استفاده از ابزارهای هوش مصنوعی و دشواری کنترل این سیستمها افزایش یافته است؛ بهویژه با توجه به اینکه توانایی این سیستمها روزبهروز بیشتر میشود.
یکی از نگرانیهای مهم این است که مدلهای پیشرفته بتوانند روشهایی برای پنهان کردن فعالیتهای خود پیدا کنند و در نتیجه، شناسایی و ردیابی اقدامات آنها دشوارتر شود. افزایش این نگرانیها، پیشنهادهایی برای کاهش سرعت توسعه هوش مصنوعی و تقویت نظارت بر سیستمهای دارای قابلیت ارتقای خودکار (Self-Improving Systems) را به دنبال داشته است.
به گفته پژوهشگران، سیستمهای هوش مصنوعی ممکن است طی چند سال آینده بخش عمده فعالیتهای پژوهش و توسعه در حوزه هوش مصنوعی (AI R&D) را خودکار کنند و در ادامه، توانایی انجام بخش قابلتوجهی از این فعالیتها را بدون دخالت مستقیم انسان به دست آورند. پژوهشگران هشدار دادهاند که اگر افزایش تواناییهای هوش مصنوعی به مرحلهای برسد که پیشرفت این فناوری با سرعت بسیار زیادی ادامه پیدا کند، سرعت توسعه قابلیتهای آن میتواند بسیار بیشتر از توان جامعه برای سازگاری با این تغییرات شود. در چنین شرایطی، انسان ممکن است کنترل خود بر سیستمهای هوش مصنوعی فرابشری را از دست بدهد و توازن قدرت میان دولتها، شرکتها و نهادهای حکومتی نیز بهشدت تحت تأثیر قرار گیرد.
سم آلتمن (Sam Altman)، مدیرعامل OpenAI، هفته گذشته در شورای امنیت سازمان ملل متحد درباره پیامدهای سیستمهای هوش مصنوعی خودمختار هشدار داد. او به سیستمهایی اشاره کرد که میتوانند قابلیتهای خود و نسخههای بعدی خود را ارتقا دهند؛ فرآیندی که به آن «ارتقای خودکار پیوسته» (Recursive Self-Improvement) گفته میشود.
آلتمن تأکید کرد که باید فعالیت این سیستمها بهطور دقیق قابل بررسی باشد و شواهد کافی وجود داشته باشد که عملکرد آنها مطابق با اهداف تعیینشده توسط انسان پیش میرود؛ حتی زمانی که سطح توانایی و هوشمندی این سیستمها بسیار بالا باشد. او تأکید کرد که حتی احتمال بسیار کم وقوع چنین فاجعهای نیز نباید نادیده گرفته شود.
منابع