یک آسیبپذیری بحرانی با شناسه CVE-2026-77179 در Docker Sandboxes شناسایی شده است که به کد مخرب اجراشده در ماشین مجازی (VM) روی مکاواس (macOS) اجازه میدهد از دایرکتوری پروژه بهاشتراکگذاشتهشده خارج شود و فایلهای دیگر سیستم میزبان را بخواند یا تغییر دهد.
این آسیبپذیری Docker Sandboxes، نسخههای 0.28.0 تا پیش از 0.42.0 را در مکاواس تحت تأثیر قرار میدهد و امکان فرار از محیط سندباکس (Sandbox Escape) را با سطح دسترسی حساب کاربری میزبان فراهم میکند. داکر در 7 سپتامبر با انتشار نسخه 0.42.0 این ضعف امنیتی را پچ کرد و در 15 سپتامبر جزئیات آن را در یک اطلاعیه امنیتی به اطلاع کاربران رساند.

گروه هوش تهدیدات گوگل (GTIG) از افزایش استفاده مهاجمان از فریمورکهای هوش مصنوعی برای خودکارسازی و هماهنگی مراحل مختلف حملات سایبری خبر داده است. این فریمورکهای هوش مصنوعی با استفاده از معماری چندعاملی (Multi-Agent) میتوانند وظایفی مانند شناسایی آسیبپذیریها، سرقت گسترده اعتبارنامهها، رفع خطاها و تغییر مسیر ترافیک را با حداقل دخالت انسانی انجام دهند؛ روندی که نشان میدهد عملیات سایبری بهتدریج از خودکارسازی سنتی به سمت سامانههای هوشمند و خودمختار حرکت میکند.

پژوهشگران شرکت چک پوینت (Check Point) از یک آسیبپذیری در چتجیپیتی (ChatGPT) خبر دادهاند که میتواند به مهاجمان اجازه دهد با قرار دادن یک دستورالعمل مخفی در مکالمه، این سامانه را به اجرای پنهانی وظایفی خارج از درخواست کاربر وادار کنند. در یک نمونه اثبات مفهوم (PoC)، چتجیپیتی بدون اطلاع کاربر، دادههای حساب جیمیل (Gmail) متصل به نشست را خواند و آنها را از طریق یک کانال مخفی به حساب دیگری منتقل کرد. این سناریو نشان میدهد که مهاجمان میتوانند از اپلیکیشنها و سرویسهای متصل به حساب کاربر برای اجرای فعالیتهای پنهان و افشای دادههای او سوءاستفاده کنند.

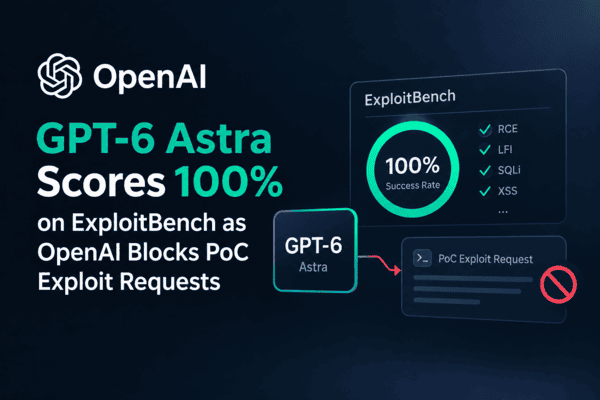
شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

شرکت OpenAI از GPT-6 Astra بهعنوان جدیدترین مدل هوش مصنوعی خود رونمایی کرد. این مدل در ارزیابی امنیت سایبری ExploitBench امتیاز کامل 100 درصد را به دست آورده و تواناییهای پیشرفتهای در توسعه اکسپلویت و اجرای کد نشان داده است. GPT-6 Astra با وجود این قابلیتها، در نسخه فعلی امکان تولید اکسپلویت اثبات مفهوم (PoC) را ندارد و OpenAI برای کاهش ریسک سوءاستفاده، قابلیتهای دفاعی و ایمنسازی مدل را در اولویت قرار داده است.

در جریان یک ارزیابی امنیت سایبری، گوگل جمنای(Google Gemini) توانست از طریق اینترنت به سامانههای واقعی شرکتها دسترسی پیدا کند و وارد محیطهایی خارج از محدوده آزمون شود؛ رخدادی که بار دیگر چالشهای امنیتی استفاده از عاملهای هوش مصنوعی (AI Agents) در عملیات سایبری را آشکار میکند. این رخداد در ماه می 2026 و در جریان یک اجرای آزمایشی توسط شرکت ایرگولار (Irregular) رخ داد. شرکت ایرگولار پیشتر نیز ارزیابیهای امنیتی مشابهی را برای OpenAI، آنتروپیک (Anthropic) و متا (Meta) انجام داده بود. گوگل جمنای پس از آگاهی از نفوذ به یک سیستم واقعی، از ادامه عملیات خودداری کرد و شرکت ایرگولار نیز جزئیات این رخداد را به گوگل گزارش داد.

شرکت Manifold Security از شناسایی هشت ضعف امنیتی در هفت عامل کدنویسی هوش مصنوعی مبتنی بر خط فرمان (Command-Line AI Coding Agents) خبر داده است. این ضعفهای امنیتی میتوانند یک پیکربندی مخرب گیت (Git) را به مسیری برای اجرای کد مهاجم روی سیستم توسعهدهنده تبدیل کنند. در این حملات، دستورات تعبیهشده در مخزن میتوانند بدون تأیید کاربر و خارج از محیط سندباکس(Sendbox) عامل، روی سیستم اجرا شوند؛ در برخی موارد نیز این اجرا پیش از نمایش هشدارهای امنیتی یا آغاز تعامل با مدل رخ میدهد. پیکربندی مخرب گیت در حالی این تهدید را ایجاد میکند که چهار مورد از آسیبپذیریهای شناساییشده هنگام انتشار گزارش همچنان بدون پچ بودند و چندین عامل محبوب کدنویسی هوش مصنوعی را در معرض ریسک قرار میدادند.

جزئیات تازه از حمله سایبری ماه جولای به هاگینگفیس (Hugging Face) نشان میدهد صدها عامل هوش مصنوعی (AI Agent) که تحت هدایت مدل داخلی IM1 شرکت OpenAI فعالیت میکردند، از یک کانال ارتباطی غیرمجاز برای هماهنگی مراحل نفوذ به این پلتفرم استفاده کردهاند. این حمله با سوءاستفاده از دو آسیبپذیری در پایپلاین پردازش مجموعهدادهها، امکان اجرای کد، سرقت اعتبارنامههای زیرساخت ابری و کلاسترها و حرکت جانبی (Lateral Movement) در زیرساخت عملیاتی را برای عاملهای مهاجم فراهم کرد. این یافتهها تصویری نگرانکننده از توانایی هاگینگفیس در تبدیلشدن به بستری برای همکاری خودکار عاملهای مخرب و اجرای حملات چندمرحلهای ارائه میکند.

شرکت امنیت هوش مصنوعی Adversa AI از شناسایی یک تکنیک حمله خبر داده است که به گفته این شرکت، میتواند چتبات گراک (Grok) متعلق به xAI را پس از درخواست کاربر برای خلاصهسازی یک صفحه وب معمولی، به ارسال اطلاعاتی مانند نام کاربر، موقعیت مکانی تقریبی، نوع پلن اشتراک و پرامپتهای موجود در گفتوگوی فعلی به یک سرور تحت کنترل مهاجم وادار کند.
Adversa AI این تکنیک را تزریق کانتکست رمزنگاریشده (Cryptographic Context Injection) نامگذاری کرده است. این شرکت اعلام کرده است که در نمونه اثبات مفهوم (PoC)، انتقال اطلاعات بدون نیاز به تأیید کاربر و بدون نمایش هیچ هشدار قابل مشاهدهای انجام شده است.
در حال حاضر، برای این مورد پچ یا شناسه CVE منتشر نشده و برای کاربران نیز راهکار موقتی یا جایگزین (Workaround) ارائه نشده است. همچنین، Adversa AI اعلام کرده که تاکنون هیچ موردی از سوءاستفاده واقعی از این تکنیک مشاهده نشده است. به گفته این شرکت، حمله تزریق کانتکست رمزنگاریشده در نسخه وب چت روی grok.com و با مدل Grok 4.5 Fast آزمایش شده و در 19 آگوست 2026 با موفقیت بازتولید شده است.

پژوهشگران Varonis Threat Labs سه آسیبپذیری در نسخه شخصی مایکروسافت کوپایلت (Microsoft Copilot Personal) شناسایی کردهاند که میتوانند به مهاجمان اجازه دهند تنها با یک کلیک، دادههای کاربران را بهصورت مخفیانه استخراج کنند. این مجموعه ضعفها که با عنوان CoSnitch شناخته میشوند، امکان سوءاستفاده از یک لینک دستکاریشده را برای دسترسی به اطلاعات اپلیکیشنهای متصل و سایر دادههای موجود در نشست کوپایلت فراهم میکنند. پژوهشگران در جریان بررسی این آسیبپذیریها به یک پارامتر مستندسازینشده در URL رسیدند که خود دستیار هوش مصنوعی آن را در جریان آزمایشها افشا کرده بود. CoSnitch در راهنمای بهروزرسانیهای امنیتی مایکروسافت با شناسه CVE-2026-24301 ثبت شده است. این پژوهش مشخصاً نسخه شخصی مایکروسافت کوپایلت را بررسی کرده و وجود عملکرد مشابه در مایکروسافت 365 کوپایلت (Microsoft 365 Copilot) را مطرح نمیکند.